[AI 데이터센터 보안] “가용성 우선 보안: AI 훈련 클러스터를 위한 IEC 62443의 4가지 시사점”


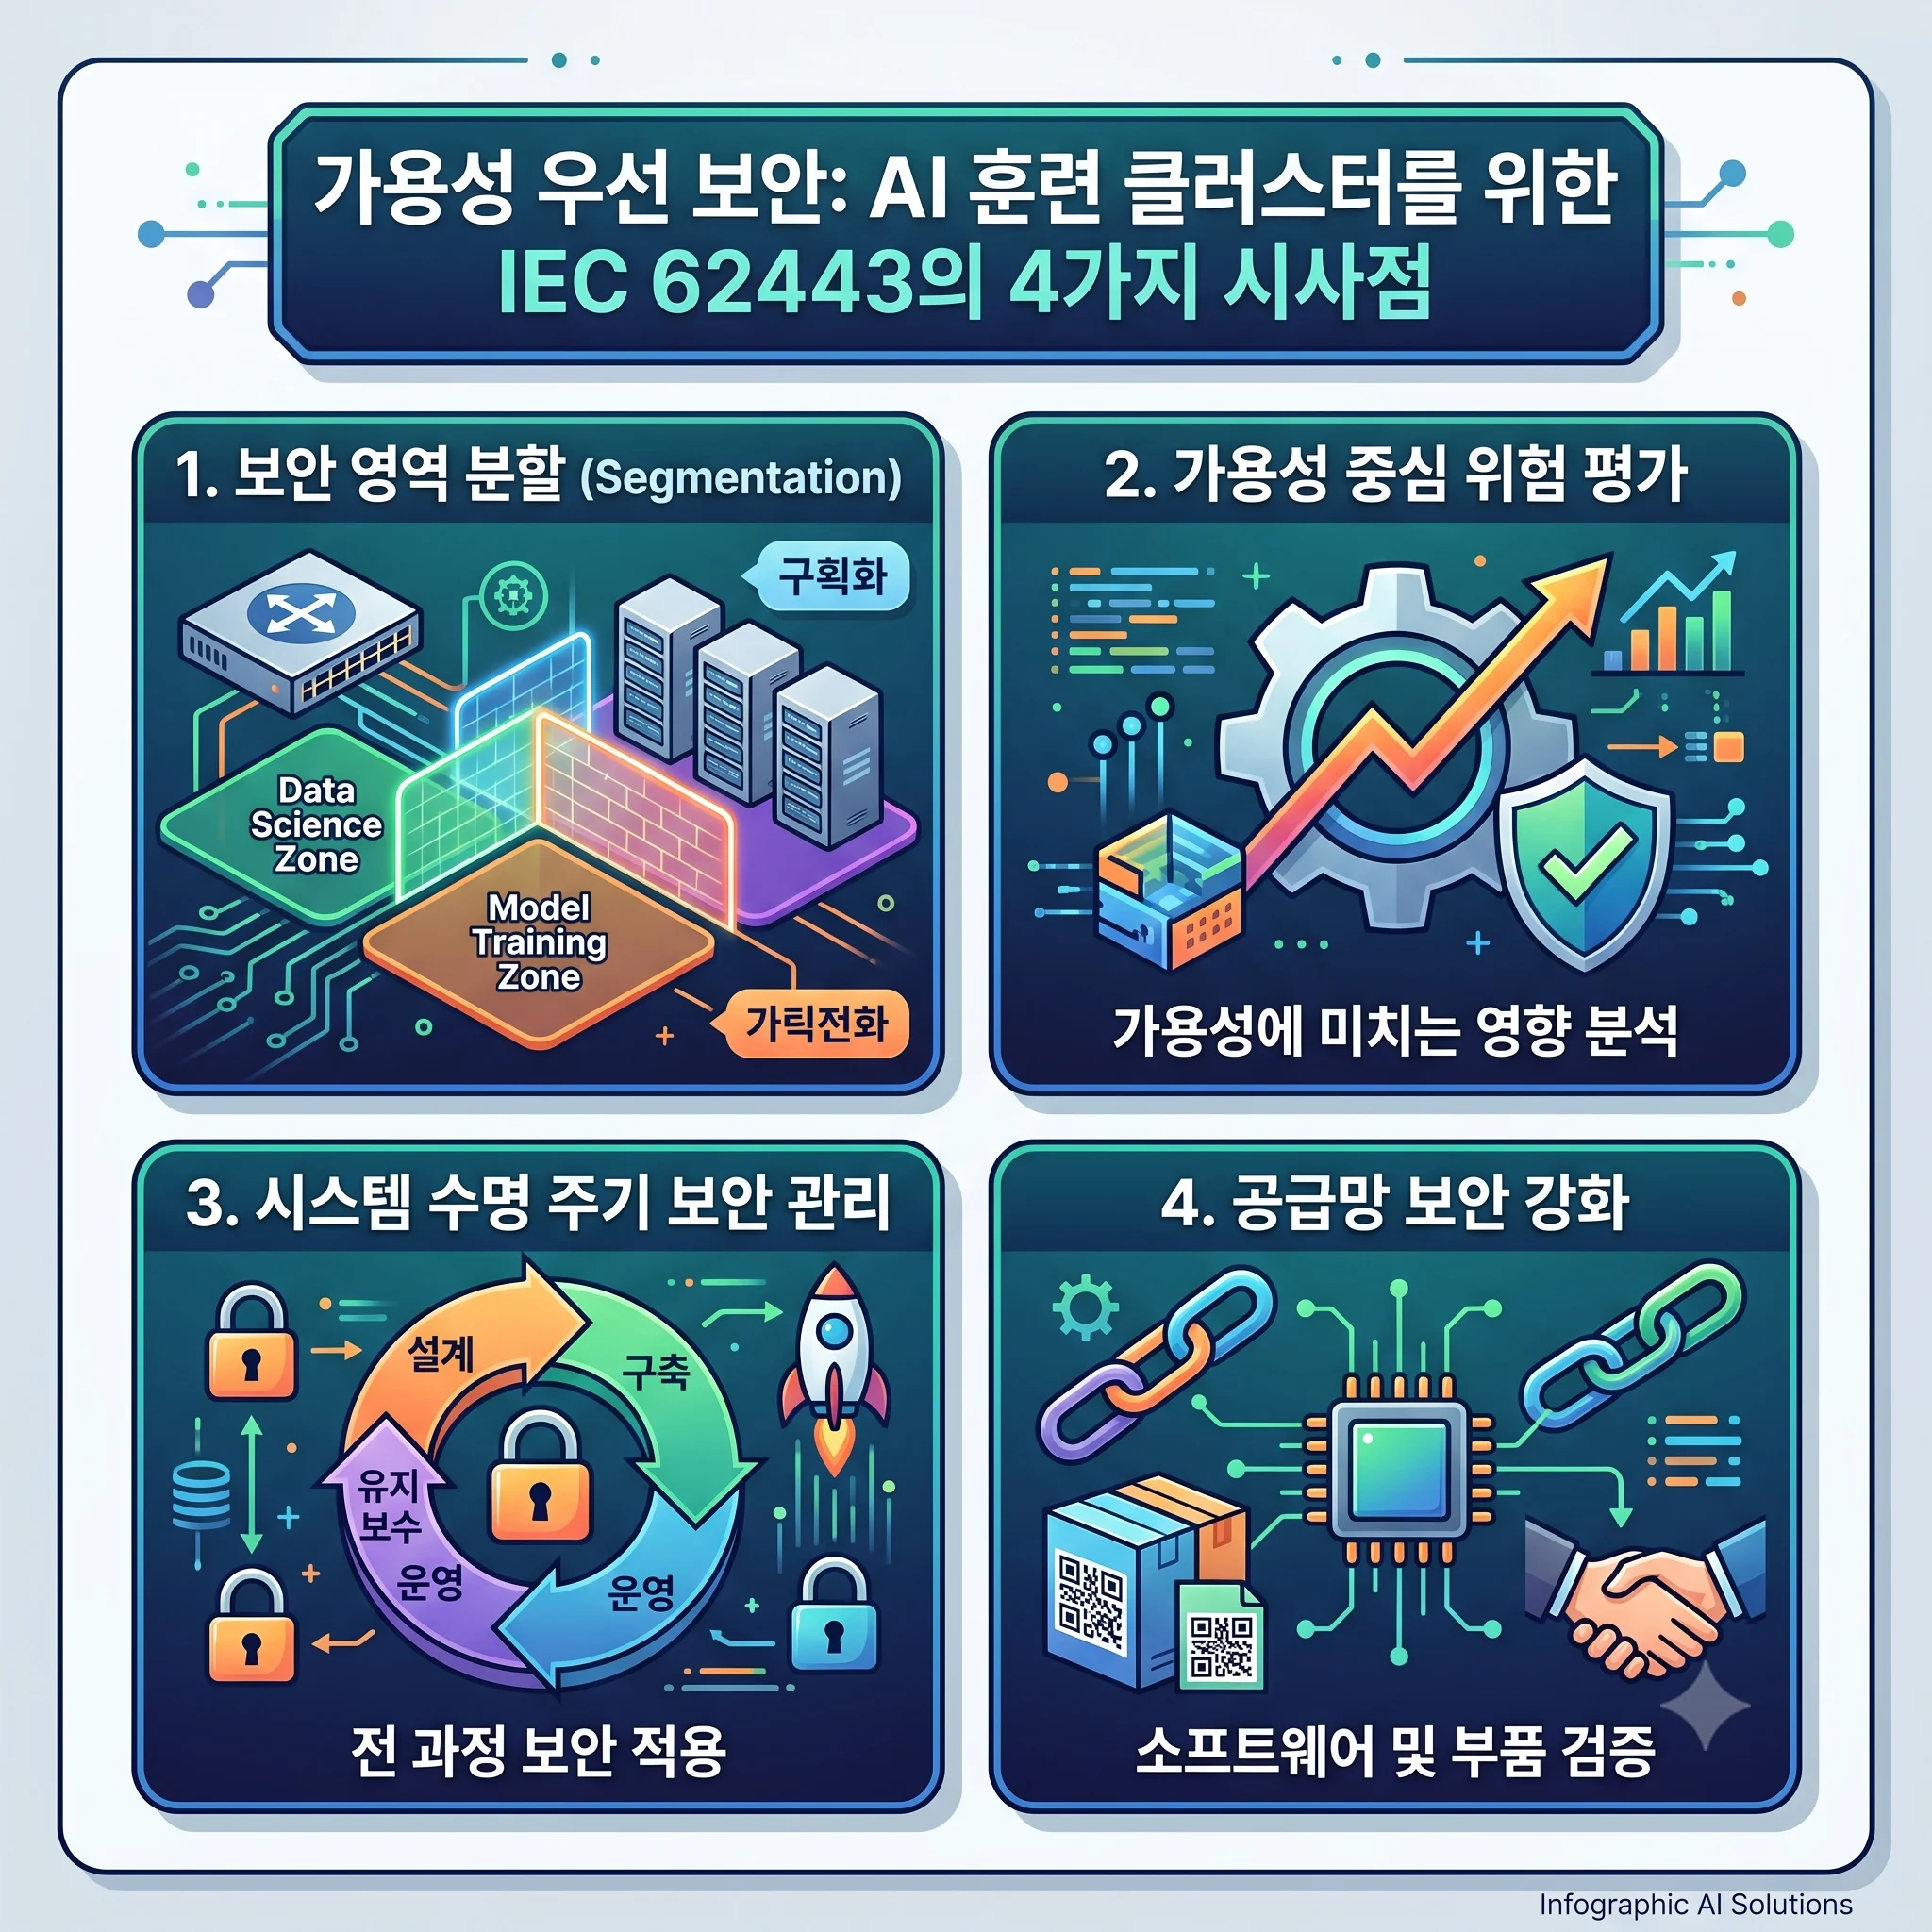
가용성 우선 보안: AI 훈련 클러스터를 위한 IEC 62443의 4가지 시사점
글 : 강진호 · OT/ICS 보안 컨설턴트
목차
제조 현장의 보안 엔지니어들은 언어모델을 훈련시키기 훨씬 이전부터 뼈아픈 교훈 하나를 배웠다. 생산 라인을 멈춰 세우는 보안 통제는 보안 개선이 아니라, 컴플라이언스 배지를 단 새로운 장애 유형일 뿐이라는 것이다. 이 원칙은 ISA/IEC 62443 표준에 “자원 가용성(Resource Availability)”이라는 이름으로 명문화되어 있으며, OT 보안이 늘 IT 보안과 다르게 설계되어 온 이유이기도 하다. AI 훈련 클러스터도 이제 정확히 같은 벽에 부딪히고 있다. 수 주간 이어지는 훈련 한 번이 수백만 달러 상당의 GPU 시간을 대표하는 상황에서는, 가용성 우선 보안이 철학적 입장에서 벗어나 워크로드의 경제성과 충돌하지 않는 유일한 접근법이 된다. 수년간 제조 현장에 IEC 62443의 가용성 우선 보안 원칙을 적용해 왔고, 이 트레이드오프 자체를 주제로 박사논문 연구를 진행해 온 입장에서, 이것이야말로 OT 보안이 AI 인프라 팀에 줄 수 있는 가장 이식 가능한 교훈이라고 생각한다.
AI 훈련 클러스터에 표준 IT 보안 방식이 아닌 가용성 우선 보안이 필요한 이유
현대 훈련 작업의 규모는 보안이 개입하기도 전에 이미 가용성을 취약하게 만든다. Meta가 직접 공개한 자료에 따르면, 16,384개의 H100 GPU 클러스터에서 54일간 Llama 3를 훈련하는 동안 총 466건의 작업 중단이 발생했다 – 계획된 중단 47건, 예상치 못한 중단 419건이며, 이 중 약 78%가 확인되었거나 의심되는 하드웨어 문제로 인한 것이었고, GPU 관련 문제만으로도 전체의 58.7%를 차지했다(Meta AI, “The Llama 3 Herd of Models,” 2024). 이런 대량의 장애에도 불구하고, 해당 팀은 빠른 탐지와 빠른 복구를 부차적인 문제가 아니라 최우선 엔지니어링 과제로 다룸으로써 90% 이상의 유효 훈련 시간을 달성했다. 이 규모에서는, 전체 클러스터에 걸쳐 실행되는 작업의 평균 장애 간격(MTTF)이 약 2.7시간으로 추정되며, 1,024-GPU 규모 작업의 약 7.9시간과 비교된다(TrainMover, 2024, Meta의 자체 운영 데이터 인용). 이것이 바로 가용성 우선 보안 프로그램이 반드시 감안해야 할 기본 현실이다 – 이미 가동 시간의 상당 부분을 장애 복구에 쓰고 있는 시스템에는, 그 위에 추가적인 다운타임을 얹는 보안 통제를 흡수할 여유가 전혀 없다는 점이다.
IEC 62443의 7번째 기본요구사항: 명문화된 가용성 우선 보안
IEC 62443-3-3은 기술 요구사항을 7개의 기본요구사항(FR) 그룹으로 구성하는데, 그중 일곱 번째인 자원 가용성(Resource Availability)이야말로 이 표준이 가용성 우선 보안 철학을 암묵적으로가 아니라 명시적으로 문서화한 지점이다(Fortinet; UpGuard, 2025). FR7은 8개의 세부 시스템 요구사항으로 나뉜다 – 시스템이 공격을 받았을 때 완전한 장애가 아니라 사전에 정의된 저하 모드로 진입하도록 요구하는 서비스거부(DoS) 보호(SR 7.1); 보안 도구를 포함한 어떤 프로세스도 공유 컴퓨트나 메모리를 고갈시키지 못하도록 하는 자원 관리(SR 7.2); 운영 중인 시스템을 손상시키지 않으면서 무결성이 보장된 백업을 요구하는 제어시스템 백업(SR 7.3) 및 복구(SR 7.4); 그리고 비상전원 및 최소기능 구성을 다루는 연속성 요구사항이다 (UpGuard, 2025). 전체적으로 보면 FR7은 보안 프로그램에 덧붙여진 체크리스트가 아니라, 가용성 우선 보안을 여덟 개의 구체적이고 검증 가능한 엔지니어링 요구사항으로 명문화한 것이다. IEC 62443 작성자들은 가용성이 핵심인 시스템 위에서 살아남지 못하는 통제는 결국 그 시스템을 운영하는 사람들에 의해 무력화될 것이라는 점을 정확히 전제하고 있었다.
그림 1 – IEC 62443-3-3 FR7(자원 가용성): 가용성 우선 보안을 구성하는 8개 시스템 요구사항
제 박사논문 연구가 밝혀낸 것: IT중심 통제가 가용성에 미치는 부(-)의 영향
이는 저에게 단순한 표준 문구가 아니라, 제조 환경의 OT 보안 통제 항목 우선순위화를 다룬 제 박사논문 연구의 핵심 결론입니다. ISO/IEC 27001, IEC 62443-3-3, NIST CSF 세 표준을 통합해 구성한 13개 항목·39개 통제 체계를 대상으로, 전문가 100명을 대상으로 한 설문 데이터에 다중회귀분석을 적용한 결과, IT중심 보안 통제의 강도와 제조 가용성 성과 사이에 통계적으로 유의한 부(-)의 관계가 확인되었습니다. 쉽게 말해, 보안 프로그램이 잦은 패치 주기·상시 엔드포인트 스캐닝·일률적인 접근권한 검토 주기처럼 IT의 기본 전제를 가용성 우선 보안 모델에 맞게 조정하지 않고 그대로 들여올수록, 지키고자 했던 바로 그 가동률을 측정 가능한 수준으로 저해했다는 뜻입니다. 이것이 OT나 AI 시스템을 보안하지 말아야 한다는 주장은 결코 아닙니다. 오히려 동일한 통제라도 IT식 기본값이 아니라 가용성 우선 보안 관점에서 설계했을 때와 그렇지 않았을 때, 순이익에서 순손실로 뒤바뀔 수 있다는 점을 인식해야 한다는 주장입니다. GPU 클러스터를 위한 보안 도구를 검토 중인 AI 인프라 팀들은 지금 이 순간에도 동일한 결정에 직면해 있으며, 대부분은 참고할 회귀분석 결과조차 없는 상태에서 그 결정을 내리고 있습니다.
그림 2 – 가용성 우선 보안의 트레이드오프: 통제 강도 대비 실측 가용성 영향(박사논문 회귀분석, N=100)
GPU 클러스터에 FR7 적용하기: 완전 정지가 아닌 저하 모드
FR7을 GPU 클러스터 언어로 옮기면 추상적인 원칙이 아니라 구체적인 가용성 우선 보안 설계 패턴이 만들어진다. SR 7.1의 사전 정의된 저하 모드는, 훈련 패브릭에서 이상 징후가 감지되었을 때 수천 개 GPU에 걸친 진행 중인 집단 연산(collective operation)을 파괴하는 갑작스러운 네트워크 차단이 아니라, 통제된 체크포인트-일시정지 시퀀스를 트리거하는 규칙이 된다 – 이는 산업제어시스템에 요구되는 가용성 우선 보안의 우아한 성능저하(graceful degradation) 논리와 동일하다. SR 7.2의 자원 관리는, 훈련 노드에서 실행되는 보안 에이전트가 고정되고 작은 몫의 호스트 CPU와 메모리만을 사용하도록 제한함으로써, 엔드포인트 모니터링이 패브릭 동기화를 좌우하는 데이터 로더 스레드나 NCCL 프로세스와 절대 경쟁하지 못하도록 하는 하드 제약이 된다. SR 7.3과 7.4는 체크포인트 무결성과 직접 대응된다 – 보안 주도의 백업이나 스냅샷 프로세스는 훈련 작업이 자체 체크포인트를 쓰는 데 사용하는 것과 동일한 스토리지 대역폭을 절대 건드려서는 안 된다. 체크포인트 쓰기 속도가 이미 병목인 시스템에서 그 대역폭을 두고 경쟁하는 것은 사실상 표준이 명시적으로 경고하는 서비스거부(DoS) 상황이기 때문이다. 그리고 SR 7.7의 최소기능 원칙은, 훈련 패브릭 존 내부 노드에는 가능한 한 얇은 보안 발자국만 남기고, 더 무거운 검사와 로깅은 오케스트레이션 및 엔터프라이즈 경계로 옮기라고 말한다 – 이는 OpenAI의 데이터센터 보안 채용공고가 OT 인접 네트워킹 환경에서의 운영 제약에 대한 보완통제를 명시적인 직무 요건으로 서술하는 지점과 정확히 일치한다.
트레이드오프를 잘못 설계했을 때의 비용
경제성만 놓고 봐도 답은 명확하다. Meta의 이전 OPT-175B 훈련은 992개의 A100 GPU로 이상적으로는 25일이면 끝났어야 했지만 실제로는 약 57일이 걸렸고, 이는 전체 시간의 약 56%가 실제 훈련이 아니라 장애 처리에 소모되었다는 뜻이다 (“Efficient Training of Large Language Models on Distributed Infrastructures” 서베이 논문 인용, 2024). Meta의 Llama 3.1 405B 훈련에 대한 독립적인 분석은, 잘 최적화된 구성에서도 체크포인팅과 복구 오버헤드가 전체 훈련 시간의 약 2.1%에 달하며, 극단적인 규모에서는 이 오버헤드가 관리되지 않을 경우 결국 훈련 자체를 불가능하게 만들 정도로 가파르게 증가한다는 점을 보여준다(Epoch AI, 2025). 운영 측면에서는, Amazon의 SageMaker HyperPod 공식 문서에 따르면 256-인스턴스 클러스터에서 장애가 발생한 인스턴스 하나를 교체하는 데 약 940초가 걸리고, 이후 전체 훈련 작업을 재개하는 데 약 2,390초가 걸린다 – 이 비용은 장애의 원인이 하드웨어 결함이든 과도한 보안 통제이든 관계없이 유휴 GPU 시간으로 그대로 지불된다(AWS, 2025). 이 수치들 중 어느 것도 보안 오버헤드를 포함하지 않는다. 이는 방화벽 규칙 하나, 엔드포인트 에이전트 하나가 추가되기도 전에 AI 인프라 팀이 이미 소진하고 있는 가용성 여유분을 보여줄 뿐이다. 가용성 우선 보안은 바로 그 여유분이 더 이상 무너지지 않도록 지키는 역할을 한다.
그림 3 – 보안이 더해지기 전, 대규모 훈련이 이미 소진하고 있는 가용성 우선 보안 여유분
정리하며
IEC 62443의 FR7은 GPU 패브릭이 아니라 PLC를 위해 작성된 조항이며, 그 문구가 그대로 이식되리라 기대해서는 안 된다. 하지만 그 안에 담긴 원칙 – 강제로 멈추기보다 우아하게 성능을 낮추고, 자신의 자원 사용량을 스스로 예산 안에 두며, 백업 프로세스가 보호 대상 워크로드와 절대 경쟁하지 않도록 하는 것 – 은 가용성 우선 보안이 가장 이식 가능한 형태로 압축된 것이며, AI 훈련 인프라에도 거의 그대로 대응된다. 제 박사논문 연구는 이 원칙을 건너뛰었을 때의 위험이 결코 이론에 그치지 않는다는 것을 보여준다 – IT중심 기본값 위에 세워진 보안 통제는 제가 연구한 제조 환경에서 가용성을 측정 가능한 수준으로 떨어뜨렸으며, 다운타임에 훨씬 덜 관대한 GPU 클러스터가 예외일 이유는 없다. AI 컴퓨트 인프라를 지키는 사람에게 가용성 우선 보안은 업무의 제약이 아니라, 업무 그 자체다.
참고자료
- Meta AI, “The Llama 3 Herd of Models” (2024)
- TrainMover: An Interruption-Resilient Runtime for ML Training (2024)
- Fortinet, “IEC 62443 Standard: Industrial Cybersecurity Framework Explained”
- UpGuard, “What is IEC/ISA 62443-3-3:2013?” (2025)
- Epoch AI, “Hardware Failures Won’t Limit AI Scaling” (2025)
- “Efficient Training of Large Language Models on Distributed Infrastructures: A Survey” (2024)
- AWS, “Reduce ML Training Costs with Amazon SageMaker HyperPod” (2025)


