[AI 데이터센터 보안] “AI 데이터센터 네트워크 세그멘테이션: 퍼듀 모델이 주는 4가지 시사점”


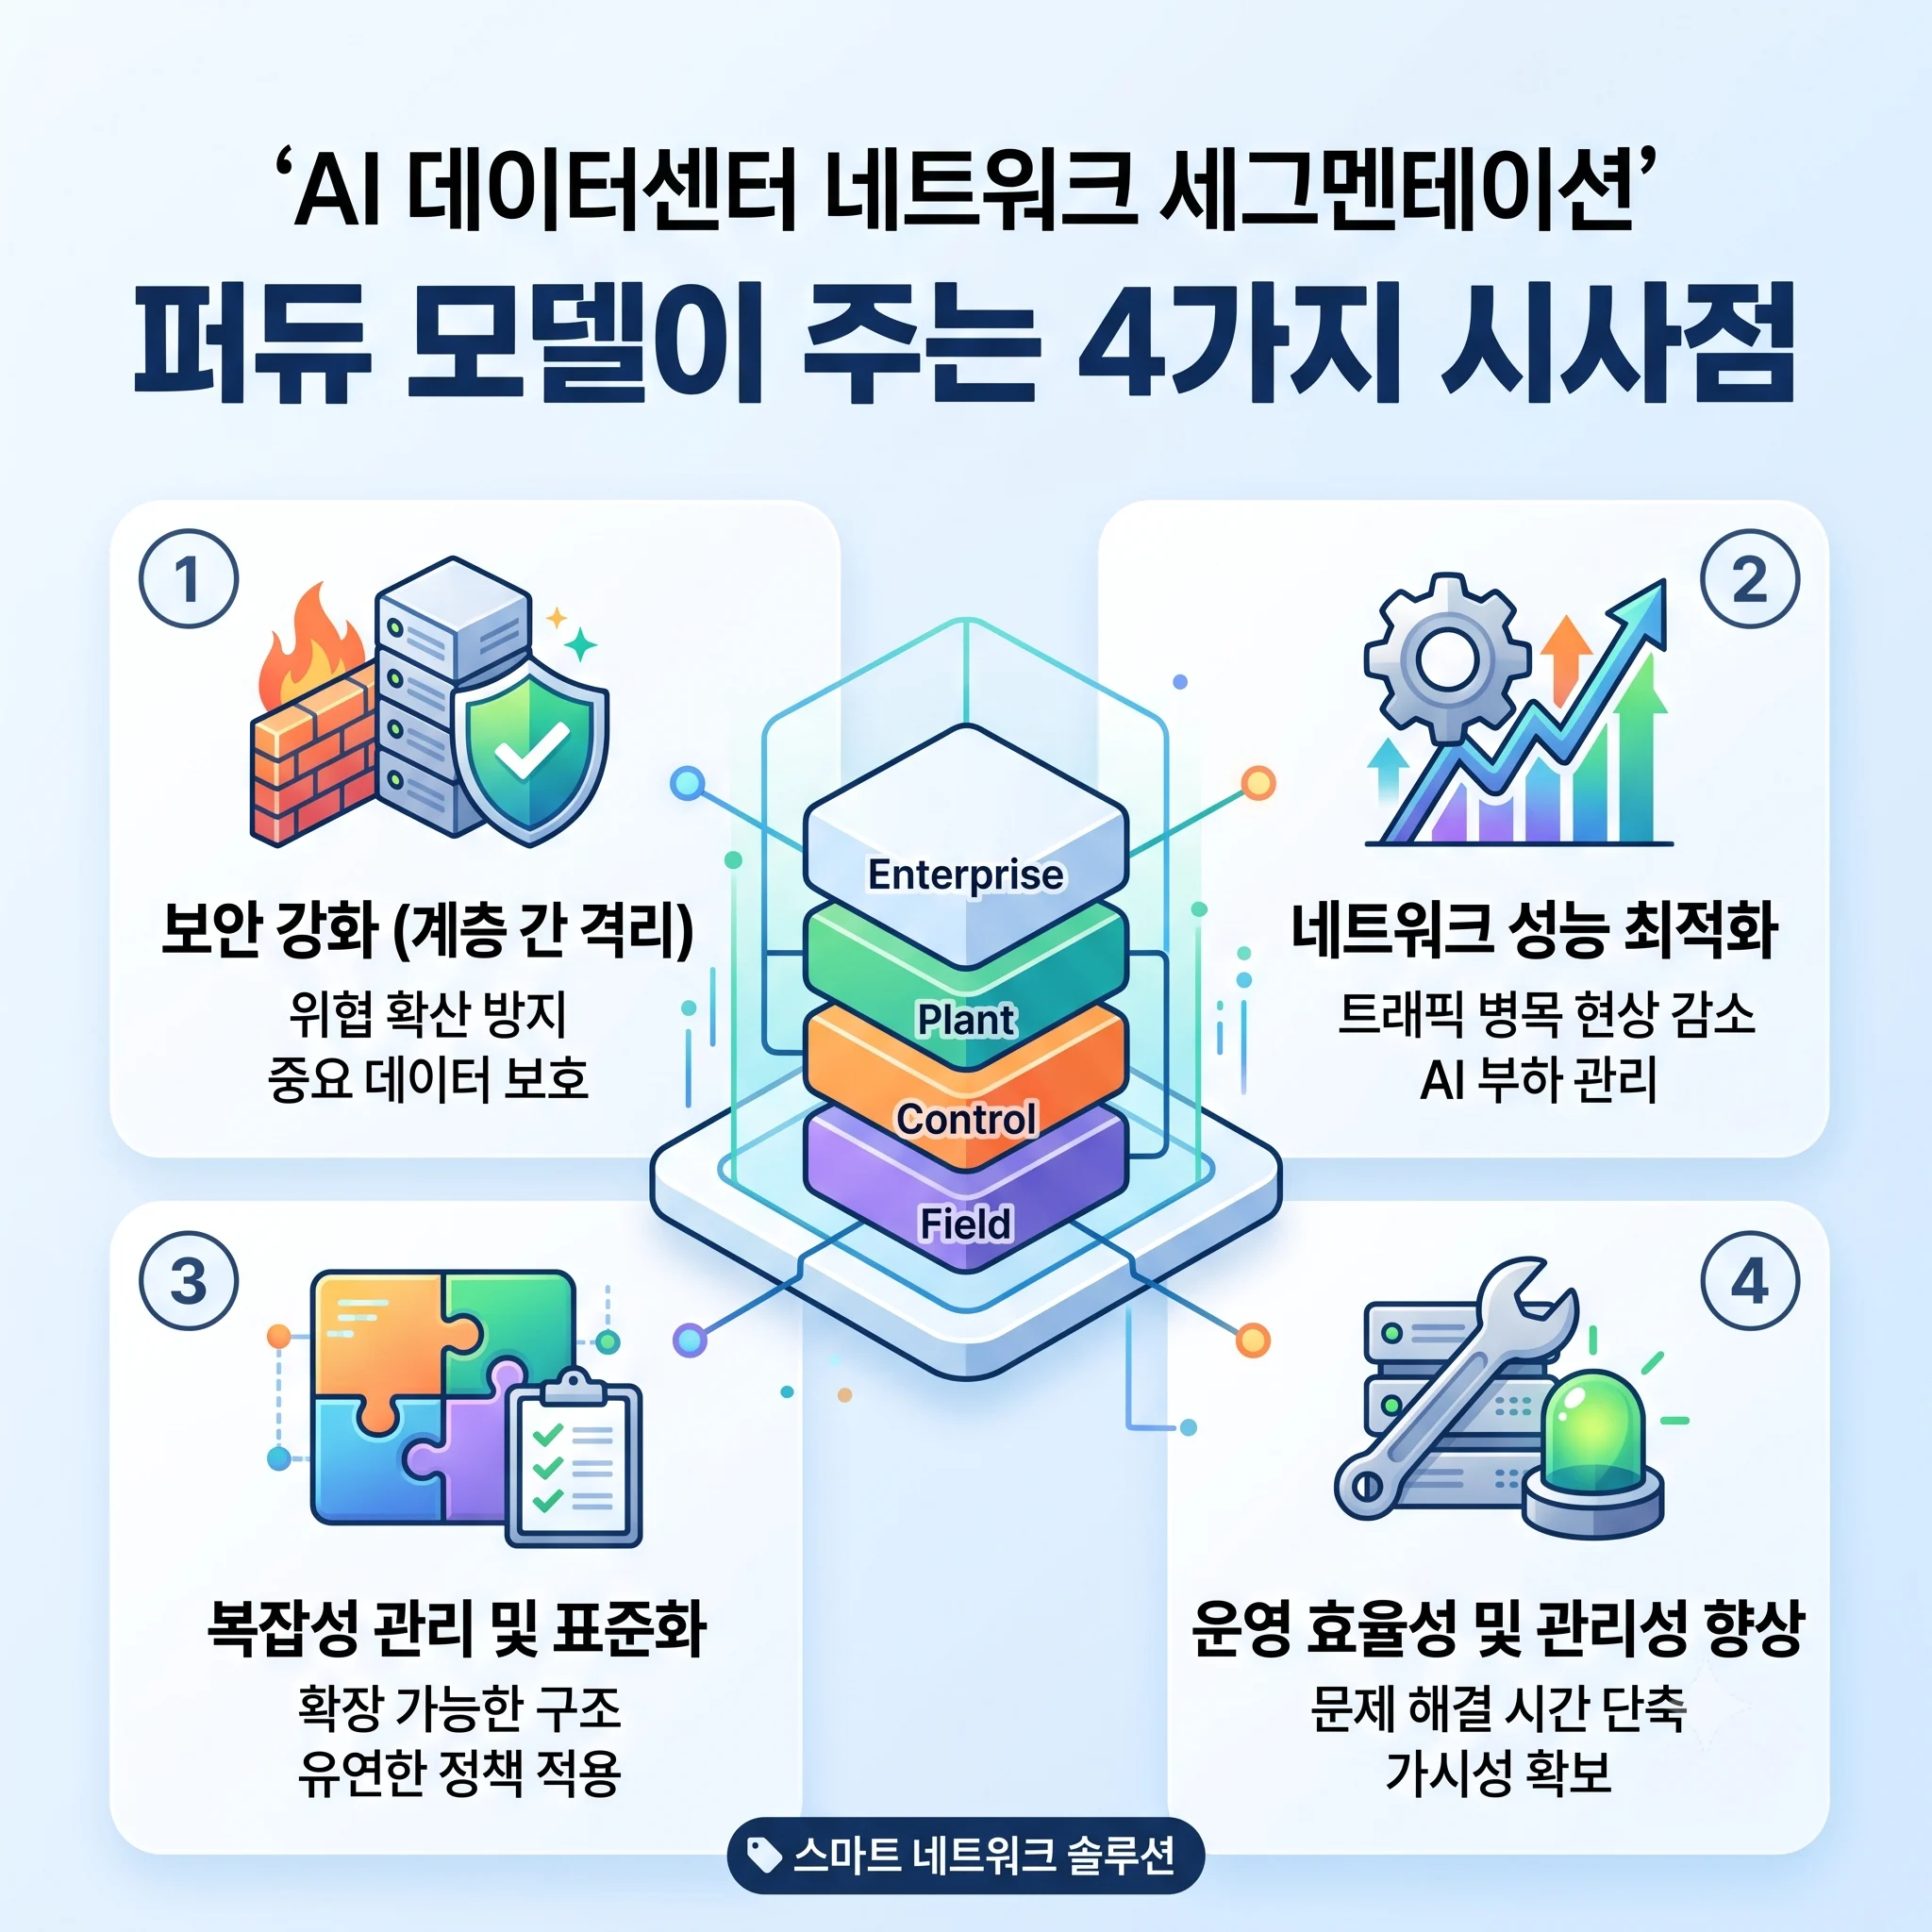
AI 데이터센터 네트워크 세그멘테이션: 퍼듀 모델이 주는 4가지 시사점
글 : 강진호 · OT/ICS 보안 컨설턴트
목차
30여 년 전 공장 네트워크를 설계했던 엔지니어들은 오늘날 AI 인프라 팀이 뒤늦게 맞닥뜨리고 있는 문제를 이미 풀어낸 적이 있다. 다운타임이 곧 막대한 손실로 이어지고, 노드 하나의 침해가 전체 시스템 장애로 번질 수 있으며, 가장 성능이 좋은 아키텍처가 동시에 가장 방어하기 어려운 구조인 환경을 어떻게 지킬 것인가 하는 문제다. 그 해답이 바로 퍼듀 엔터프라이즈 참조 아키텍처(Purdue Enterprise Reference Architecture)였고, 이를 기반으로 한 네트워크 세그멘테이션 원칙은 이제 GPU 훈련 클러스터를 지키는 사람들에게도 필독 지식이 되어가고 있다. 수년간 제조 현장에 ISA/IEC 62443과 NIST CSF 기반의 네트워크 세그멘테이션 체계를 적용해 온 입장에서, 오늘날 AI 컴퓨트 인프라와의 유사성은 무시하기 어렵다. 실제로 최근 글로벌 AI 기업들의 데이터센터 보안 채용공고에는 “OT-IT 네트워킹”과 “네트워크 세그멘테이션”이 선택 요건이 아닌 핵심 요건으로 명시되기 시작했다.
AI 컴퓨트 인프라에 OT식 네트워크 세그멘테이션이 필요한 이유
IT 보안은 오랫동안 “문제가 생기면 패치하고 재부팅하면 된다”는 전제 위에서 작동해 왔다. 그러나 GPU 훈련 클러스터는 화학 반응기나 터빈 제어시스템과 마찬가지로 이 전제를 거부하는 시스템이다. 수만 개의 가속기를 동기화하며 몇 주간 이어지는 훈련 작업은 연속 제조 라인이 예기치 않은 정지를 견디지 못하는 것과 똑같이, 계획되지 않은 재부팅을 견디지 못한다. 이때 손실은 단순한 지원 티켓이 아니라 컴퓨트 시간과 체크포인트 손상으로 측정된다. 이 단 하나의 제약이 네트워크 세그멘테이션 설계 방식 전체를 바꿔놓는다. 잦은 패치와 빈번한 네트워크 변경을 전제로 하는 전통적인 IT 보안 방식은, 가용성이 최우선인 환경에서는 애초에 감당할 수 없는 접근법이기 때문이다.
보안 연구 커뮤니티는 산업 환경에서 이미 관련 패턴을 추적해 왔다. IT와 OT 네트워크가 융합될수록, 그 상호의존성이 기존 경계 방어 모델이 막아내지 못하는 새로운 측면 이동(lateral movement) 경로를 만들어낸다는 것이다. 특히 벤더 원격접속 도구와 잘못 설정된 경계 장비를 통한 침투가 대표적이다(IBM X-Force, 2025). AI 데이터센터도 동일한 방식으로 융합되고 있다 — 기업 IT, MLOps 도구, 제3자 모델 API, 물리적으로 격리된 GPU 패브릭이 모두 하나의 조직 네트워크 안에 놓이게 되며, 이 융합이 만들어내는 측면 이동 위험은 OT 보안팀이 지난 20여 년간 씨름해 온 문제와 구조적으로 동일하다. 의도적인 네트워크 세그멘테이션이 없다면, AI 데이터센터는 OT 업계가 힘들게 배운 약점을 그대로 물려받는다 — 평평한(flat) 네트워크는 빠른 네트워크이지만, 동시에 공격자가 모든 것에 도달하는 가장 빠른 경로이기도 하다는 점이다.
60초로 이해하는 퍼듀 모델: Level 0~5와 iDMZ
퍼듀 엔터프라이즈 참조 아키텍처는 산업 환경을 기능적 계층 구조로 나눈다. 맨 아래에는 필드 장치와 센서, 그 위에는 제어시스템과 HMI, 중간에는 제조운영시스템과 이력관리 시스템, 맨 위에는 비즈니스 물류 및 기업 IT 시스템이 위치한다(Purdue Enterprise Reference Architecture, Wikipedia; NIST SP 800-82 Rev. 3). 운영 계층과 비즈니스 계층 사이에는 비무장지대(DMZ)가 존재하는데, 흔히 산업용 DMZ 또는 iDMZ라고 불리며, 유일한 역할은 기업 IT 트래픽이 제어시스템 트래픽에 직접 닿지 못하도록 막는 것이다.
그림 1 — 퍼듀 모델의 네트워크 세그멘테이션 단계와 iDMZ 경계
이 계층 구조는 원래 보안 모델로 설계된 것이 아니라 제조 기업의 정보 흐름 모델이었다. 하지만 이후 IEC 62443 표준을 만든 ISA-99 위원회가 퍼듀 레벨 구조를 그대로 Zone-and-Conduit 보안 아키텍처의 개념적 토대로 채택했다(Software Toolbox, 2026). NIST SP 800-82 Rev. 3는 여기서 한 걸음 더 나아가 네트워크 세그멘테이션 요구사항을 명문화한다 — Level 4(비즈니스 물류) 장치가 Level 2, 1, 0 장치와 직접 통신하지 못하도록 방화벽 규칙을 요구하며, 아웃바운드 규칙도 인바운드만큼 엄격하게 적용할 것을 권고한다(SentinelOne, 2026). 이 단 하나의 설계 원칙 — 기업 네트워크에서 공정제어 네트워크로 가는 직접 경로를 허용하지 않는다는 원칙 — 이 바로 이 모델의 보안적 가치 전부이며, 하나의 네트워크 세그멘테이션 정책으로 압축된다.
GPU 클러스터에 퍼듀 레벨 대입하기: 유효한 지점과 한계
현대 AI 데이터센터의 네트워크 세그멘테이션을 이 계층 구조 위에 겹쳐 보면, 예상보다 훨씬 깔끔하게 대응된다. GPU 간 백엔드 패브릭 — 가속기 사이의 그래디언트 동기화 트래픽을 나르는 InfiniBand 또는 RoCE 네트워크 — 은 지연에 극도로 민감하고 범용 IT 트래픽과 절대 섞여서는 안 된다는 점에서 Level 0/1 필드 장치 트래픽과 유사하게 작동한다. 클러스터 오케스트레이션 계층(작업 스케줄러, 패브릭 매니저)은 대략 Level 2/3에 해당하며, 물리 계층을 감독하되 그 일부는 아니다. 모델 레지스트리, 데이터 파이프라인, 내부 MLOps 도구는 Level 3/4 위치를 차지하고, 외부 공개 API와 기업 IT는 기업 시스템이 늘 있어온 자리인 Level 5에 위치한다.
그림 2 — 퍼듀 레벨 기반 네트워크 세그멘테이션을 GPU 훈련 클러스터에 대입한 구조
이 비유가 한계에 부딪히는 지점은 성능이다. 8-GPU 서버로 구성된 1,000-GPU 훈련 클러스터는 400테라비트/초를 훌쩍 넘는 all-to-all 트래픽을 거의 무손실로 소화할 수 있는 논블로킹 패브릭을 필요로 하며(The Network DNA, 2026), InfiniBand 패브릭은 노드 수가 대략 512~1,024개를 넘어서면 계층형 다중 패브릭 토폴로지로 전환하지 않는 한 포화 상태에 이르는 것으로 알려져 있다(The Neural Base, 2026). 퍼듀식 필드 네트워크는 밀리초 단위의 느리고 결정론적인 제어 루프를 위해 설계된 반면, AI 패브릭은 마이크로초 단위의 all-to-all 동기화 트래픽을 위해 설계되었고, 이는 네트워크 세그멘테이션이 애초에 상정하지 않았던 환경이다. 그럼에도 교훈 자체는 그대로 이어진다 — OT 엔지니어들이 수년간 결정론적 성능과 방어 가능한 네트워크 세그멘테이션 사이에서 협상해 온 바로 그 긴장 관계가, 이제 GPU 백엔드 패브릭을 설계하는 모든 이들의 핵심 과제가 되었으며, 패브릭 속도가 현재의 400Gb/s 세대에서 800Gb/s 이상으로 올라갈수록 그 긴장은 더 첨예해질 것이다.
Zone과 Conduit: IEC 62443이 AI 패브릭 설계에 더하는 것
IEC 62443은 퍼듀 계층 구조를 네트워크 세그멘테이션을 위한 두 가지 정밀한 개념으로 공식화한다. Zone은 공통된 보안 요구사항을 공유하는 자산 집합이며, Conduit은 Zone 사이를 잇는 통신 채널로서 가장 낮은 신뢰수준이 아니라 그것이 접하는 두 Zone 중 가장 높은 신뢰수준에 맞춰 보호되어야 한다(SentinelOne, 2026). 이 마지막 조항이야말로 IT 중심으로 훈련받은 보안팀들이 네트워크 세그멘테이션을 처음 시도할 때 가장 자주 거꾸로 이해하는 부분이다 — 저신뢰 Zone과 고신뢰 Zone을 잇는 Conduit은 고신뢰 Zone의 요구사항을 물려받아야지, 그 반대가 되어서는 안 된다.
그림 3 — AI 데이터센터 네트워크에 적용한 Zone과 Conduit 구조
이를 AI 데이터센터에 적용하면, 많은 GPU 클러스터가 여전히 운영 중인 평평하고 전면 신뢰 기반 네트워크 대신 의도적인 네트워크 세그멘테이션 구조를 제안할 수 있다 — 격리된 백엔드 RDMA 네트워크를 위한 Training Fabric Zone, 스케줄러와 패브릭 매니저를 위한 Cluster Orchestration Zone, 훈련 데이터 파이프라인을 위한 Data Ingestion Zone, 그리고 기업 시스템과 공개 API를 위한 Enterprise IT Zone이다. 이들 사이의 모든 경로는 열려 있는 통로가 아니라 명시적으로 정의되고 모니터링되는 Conduit이 된다 — 이는 10년 넘게 제조 현장에서 Level 3와 Level 4 사이 경계를 지켜온 것과 기능적으로 동일한 compute용 iDMZ를, 훈련 패브릭과 그것을 점점 더 둘러싸는 기업 네트워크 사이의 경계로 옮겨온 것에 불과하다. 이것이 바로 의도를 가진 네트워크 세그멘테이션이며, 패브릭이 이미 운영 중인 상태에서 뒤늦게 덧붙이는 네트워크 세그멘테이션과는 다르다.
비즈니스 관점: 네트워크 세그멘테이션이 실제로 가져오는 효과
이는 이론적인 논의가 아니다. IBM X-Force 팀은 2025년 상반기에만 OT 인접 환경에 영향을 줄 수 있는 취약점 670건이 공개되었으며, 이 중 11%가 CVSS 기준 심각(Critical) 등급이었다고 밝혔다(IBM X-Force, 2025) — 융합이 만들어내는 공격 표면이 계속 확대되고 있다는 신호다. 방어 측면에서는, 제로트러스트 원칙과 성숙한 네트워크 세그멘테이션(주로 마이크로세그멘테이션 도구로 구현)을 결합한 조직이 Zone 간 측면 이동 시도의 최대 95.8%를 차단했다고 보고되며, 이는 평평하고 세그멘테이션이 되지 않은 네트워크의 성과와 크게 대조된다(Elisity, 2025). 탐지 속도는 이 효과를 더욱 증폭시킨다 — IBM의 2025년 데이터 유출 비용 보고서에 따르면 전 세계 평균 침해 탐지·봉쇄 소요 기간은 241일이었으며, 200일 이내에 봉쇄된 침해는 그보다 오래 끈 침해보다 유의미하게 낮은 비용을 기록했다(IBM Cost of a Data Breach Report, 2025). 잘 설계된 네트워크 세그멘테이션은 단순히 측면 이동 성공 확률을 낮추는 데 그치지 않는다 — 피해 범위와 탐지 소요 시간을 동시에 줄이며, 이는 사고가 한 Zone 안에 머무는지 아니면 AI 기업의 핵심 자산인 훈련 데이터와 모델 가중치까지 도달하는지를 가르는 결정적 조합이다.
그림 4 — 성숙한 네트워크 세그멘테이션이 침해 결과에 미치는 영향
정리하며
퍼듀 모델을 AI 데이터센터에 그대로 이식할 수는 없다 — 트래픽 패턴, 하드웨어 교체 주기, 대역폭 요구사항이 너무 다르기 때문이다. 하지만 그 안에 담긴 네트워크 세그멘테이션 원칙은 거의 수정 없이 그대로 옮겨진다: 편의가 아니라 중요도를 기준으로 Zone을 정의하고, Zone 사이의 모든 Conduit을 지름길이 아닌 보안 경계로 취급하며, 고신뢰 Zone이 저신뢰 Zone의 전제를 물려받는 일이 없도록 하는 것이다. OT에서 AI 인프라로 전환하는 보안 전문가에게 네트워크 세그멘테이션은 두 분야를 잇는 진짜 다리다 — 전혀 새로운 분야를 배우는 것이 아니라, 이미 익숙한 원칙을 셋포인트 대신 그래디언트가 흐르는 네트워크에 적용하는 일일 뿐이다.
참고자료
- NIST SP 800-82 Rev. 3, Guide to Operational Technology Security
- Purdue Enterprise Reference Architecture — Wikipedia
- Software Toolbox, “What is the Purdue Model?” (2026)
- SentinelOne, “What Is the Purdue Model? Definition, Levels & Best Practices” (2026)
- IBM X-Force, “The Operational Technology Threat Landscape” (2025)
- Elisity, “Maximizing Microsegmentation ROI: Essential KPIs for Security Leaders” (2025)
- IBM Cost of a Data Breach Report 2025 (via DataBreachCost.com)
- The Network DNA, “AI Data Center Networking: How GPU Clusters Are Changing Network Design” (2026)
- The Neural Base, “InfiniBand for Training Clusters” (2026)


